製品概要説明
ℹ️
データプライバシー声明
Lixel CyberColor Studio (Linux Server) はデータプライバシーを中核原則とし、機微な情報が常にお客様のプライベート環境内に留まることを保証する。本ソフトウェアはお客様が管理する Docker 環境内でのみ動作し、業務システムとのすべてのやり取りは読み取り操作に限定され、お客様の認可のもとで行われるため、書き込み権限やデータ変更は発生しない。 主要なデータプライバシー対策は以下のとおりである。
- 隔離処理:LCC ソフトウェアはお客様のプライベートインフラ内で完全にデータを処理し、設計上、外部サーバーや第三者サービスへのデータ転送を必要とせず、実行もしない。
- 認可駆動のアクセス:業務システムから発行されるすべての API 呼び出しは、お客様が提供するアクセスキーによって認証され、認可されたやり取りのみが発生することを保証する。
- 外部データを読み取らない:本ソフトウェアは指定された作業ディレクトリ内のデータのみを厳格に操作し、お客様のプライベートサーバーやその他の外部システムのデータにアクセス・読み取り・転送を行わない。
- お客様による制御:すべての入力ディレクトリおよび出力ディレクトリはお客様が定義し、データフローに対する完全な制御をお客様に付与するとともに、社内のデータガバナンスポリシーへの準拠を保証する。
製品紹介
LCC Studio (Linux Server) は高効率かつ拡張性の高いコンテナ化製品であり、本ソフトウェアは単一マップ再構築、地図融合、空地融合の複数の再構築モードに対応し、クラスタ計算能力を備えることで大規模な3D再構築タスクを高効率に処理する。Docker 技術をベースに、LCC 再構築ソフトウェアは業務システムとシームレスに統合でき、柔軟なデプロイに対応し、マルチGPU 並列計算を十分に活用することで再構築性能を大幅に向上させる。さらに、本ソフトウェアは開発者がデータをエクスポートすることを許可し、二次開発やエコシステムアプリケーションの拡張を容易にする。
機能概要
説明:単一マップ再構築、地図融合、空地融合、開発者データ、クラスタモードはいずれも高度な機能(付加価値サービス)であり、製品が具体的に含む機能はユーザーのニーズに応じて決まる。詳細は XGRIDS のイノベーション営業までお問い合わせいただきたい。
- マルチモード再構築:単一マップ再構築、地図融合、空地融合の再構築に対応し、採集手法が規範に沿っている場合、本バージョン製品では最大で推奨500min 以内の地上スキャン時間、15000枚以内のドローン画像による3DGS 再構築に対応し、多様なシーンモデリングのニーズに適用できる。
- 高効率計算:地図融合、空地融合に対するマルチGPU 並列アクセラレーションのみに対応し、再構築性能を大幅に向上させ、大規模データ処理のニーズを満たす。
- データ開放性:開発者データエクスポートに対応し、二次開発やエコシステムアプリケーションの拡張を容易にする。
- システム互換性:HTTP API を提供し、他の業務システムとの高効率な統合を容易にし、自動化処理とアプリケーション拡張を実現する。
- アルゴリズムのアップグレード:本バージョンで採用するアルゴリズムは、メモリ使用量とディテール効果を最適化している。
- ライセンス方式:本バージョンはオンラインライセンス、オフラインハードウェアライセンス、オフラインソフトウェアライセンスに対応する
ワークフロー
説明:ソフトウェアの起動時、XGRIDS サーバーから認証情報のみを取得する。この過程では、サーバーとのやり取りは発生するものの、作業データは関与しない。この過程はライセンス検証に限定され、システムへの安全なアクセスを保証し、お客様のプライベートデータへのアクセス・転送・処理は行わない。
製品アーキテクチャ
レイヤー
レイヤー
分散
コンピューティング
フレームワーク
リソースレイヤー
基盤
業務統合
データ準備
- ドキュメントの要件に従い、入力データを指定された作業ディレクトリに整理する。
マルチマップ融合再構築の起動
- 提供される HTTP API を使用して再構築タスクを起動する
進捗の監視
- API をポーリングしてリアルタイムのステータス更新を取得し、タスクが完了するまで続ける
構成要件
ハードウェア説明
LCC 再構築タスクの性能は主に CUDA Core と FP32 TFLOPS(毎秒浮動小数点演算)の影響を受ける。グラフィックスカードの NVLink、Tensor Core(AI 演算能力)、FP64 などの特性やビデオメモリ(≥32GB)との関係は比較的小さい。したがって、一部のハイエンド AI カード(A100、H100 など)の性能は、より高い CUDA Core と FP32 演算能力を持つ一部のローエンド型番(A10、L40 など)に及ばない場合すらある。
LCC 再構築タスクの性能分布:
LCC 再構築フローは大きく2つの部分に分けられる:
- GPU 集約型アルゴリズム:全体の約半分を占め、この部分のタスクは GPU 性能、とりわけ CUDA Core と FP32 演算能力の影響を大きく受ける。
- CPU 集約型アルゴリズム:全体の約半分を占め、GPU の性能はこの部分の計算時間への影響が小さい。
したがって、GPU 性能は GPU 集約型部分の再構築時間にのみ顕著な影響を与える。一方、CPU 集約型部分については、CPU の性能がより重要な役割を果たす。
グラフィックスカード推奨
グラフィックスカードを選定する際は、タスクの要件と予算に応じて適切な型番を選ぶことを推奨する。以下は当社が推奨するグラフィックスカードの一覧であり、性能順に並べている:
- L40:再構築タスクにおいて、L40 はより強力な Core と FP32 能力により、最良の性能を提供する。
- RTX 4090:コンシューマー向けのハイエンドグラフィックスカードとして、RTX 4090 は優れた CUDA Core 性能と高効率な FP32 計算を提供し、ほとんどの LCC 再構築タスクに適している。
- RTX 4090 D:国内特別供給版。
- L20:L40 と比較して、L20 は依然として高い CUDA Core と FP32 演算能力を維持しており、性能要求が高いが予算が比較的限られているユーザーに適している。
- RTX 3090:性能は RTX 4090 よりやや低いものの、多くの再構築タスクにおいて依然として非常に強力な性能を提供し、コストパフォーマンス要求の高いユーザーに適している。
- A10:予算が比較的限られているユーザーに適しており、性能は上記のいくつかのグラフィックスカードより低いものの、基本的な LCC 再構築タスクのニーズは依然として満たすことができる。
注意:
- ビデオメモリ:ビデオメモリの容量(≥24GB)は LCC 再構築タスクへの影響が比較的小さく、極めて大規模なシーンを処理する場合を除き、推奨される GPU 枚数の区間内では、ビデオメモリを増やしたりビデオメモリが 32GB を超えるグラフィックスカードを使用したりしても、タスク効率の向上に対する効果は限定的である。
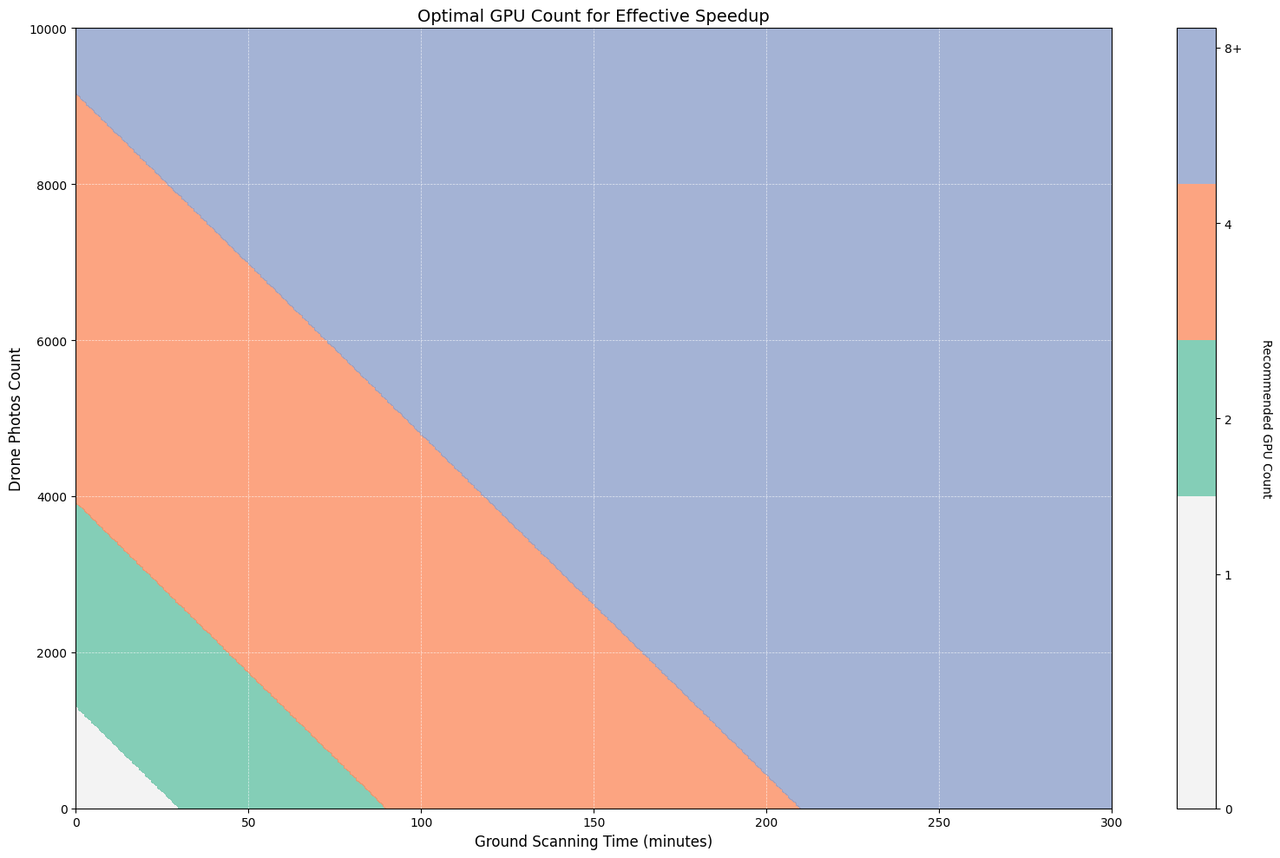
- マルチカード構成:比較的大きなシーンを再構築する場合、マルチGPU はアクセラレーション効果を生み出せる。シーンの大きさ(スキャン時間+ドローン画像数)と使用可能な最大 GPU カード枚数の関係は表のとおりである。
下表は GPU 性能参照表であり、赤色で * が付いた型番は実際に比較を行った型番で、比較的正確な相対演算能力の見積もりがある。その他の型番は類似アーキテクチャに基づいて見積もったものである。
| 型番 | CUDA Core | FP32 TFLOPS | 相対演算能力 |
|---|---|---|---|
| RTX 5090/ RTX 5090 D | 21760 | 104.8 | 1.27~1.33 |
| RTX 6000 Ada | 18176 | 91.06 | 1.1~1.11 |
| L40 | 18176 | 90.52 | 1.1~1.11 |
| RTX 4090* | 16384* | 82.58* | 1.00* |
| RTX 4090 D* | 14592* | 73.54* | 0.89* |
| H100 PCIe 96G | 16896 | 62.08 | 0.75~1.03 |
| H800 PCIe 80G | 14592 | 51.22 | 0.62~0.89 |
| L20 | 11776 | 59.35 | 0.72~0.72 |
| RTX A6000 | 10752 | 38.71 | 0.64~0.67 |
| RTX 3090* | 10496* | 35.58* | 0.62* |
| A10 | 9216 | 31.24 | 0.54~0.54 |
| L4 | 7424 | 30.29 | 0.37~0.45 |
| A100/A800 | 6912 | 19.49 | 0.34~0.41 |
| RTX 3060* | 3584* | 12.74* | 0.22* |
| RTX 2060 Laptop* | 1920* | 4.608* |
マルチカード構成
- 比較的大きなシーンを再構築する場合、マルチGPU はアクセラレーション効果を生み出せる。シーンの大きさ(地上スキャン時間+ドローン画像数)と使用可能な最大 GPU カード枚数の関係は表のとおりである。